近年、生成AIの登場は日々の業務に大きな変革をもたらしており、データ分析やデータ利活用の実務も例外ではありません。これまでは高度な専門知識を持つデータサイエンティストなどの専門家に依存していた領域が、現場の実務担当者自身の手で手軽に実行できるようになりつつあります。
本記事では、「AI全盛の今、データ分析の実務がどのように変わり、私たちはどう変わっていくべきなのか」というテーマについて、具体的なAI活用事例や、AIの分析結果を鵜呑みにしないためのチェックポイントを交えて解説します。
AIでデータ分析業務はどう変わったか
生成AIの登場によるデータ分析業務の変革は、大きく分けて「リードタイムの短縮」と「扱えるデータ形式の拡大」の2点に集約されます。
1. リードタイムの大幅な短縮
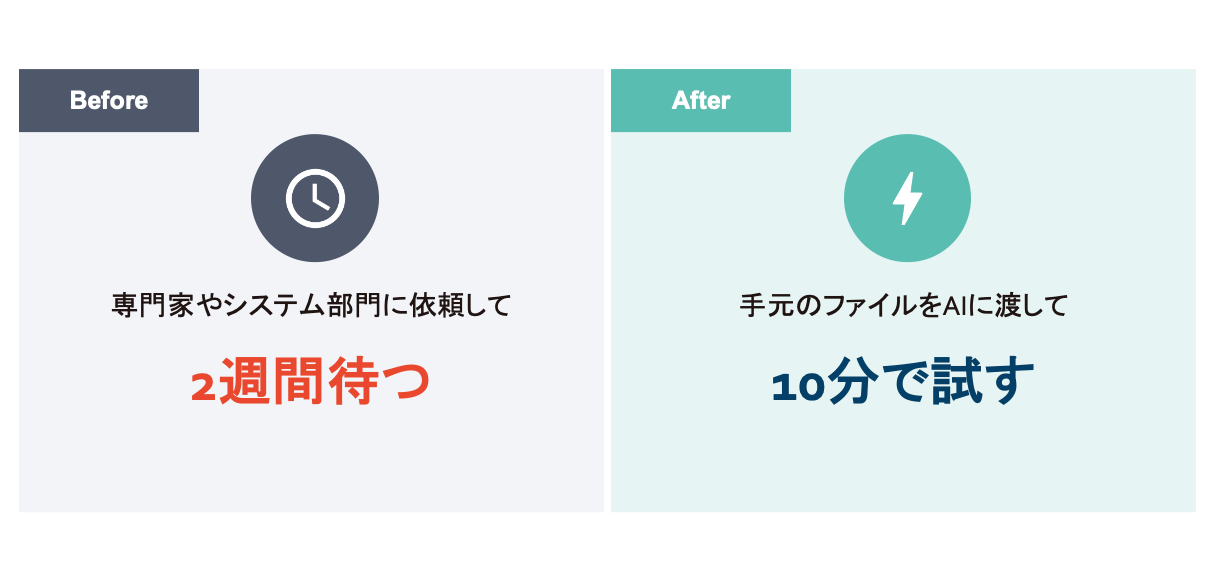
これまで、手元のデータを分析したい場合、社内の情報システム部門や外部のデータサイエンティストといった有識者に「このデータを渡すから分析してほしい」と依頼し、結果が出てくるまでに2週間から3週間程度待つのが一般的でした。
しかし、生成AIの登場により、手元のファイルをそのままAIに渡し「このように分析してほしい」と指示(プロンプト)を出すだけで、すぐに結果が返ってくるようになりました。
数週間かかっていたリードタイムがほぼゼロ(長くても数十分程度待てば結果が得られる)になったことは、非常に大きな変化です。
2. 扱えるデータ形式の拡大
これまでのデータ分析は、ExcelやCSVのような数値や表データ(いわゆる構造化データ)が中心でした。現在もこれらが分析の中心であることに変わりはありませんが、AIの進化により、WordファイルやPowerPointの企画書・セミナー資料、日報などの「自由記述のテキストデータ(非構造化データ)」もそのままAIに渡し、分析の材料として扱えるようになりました。
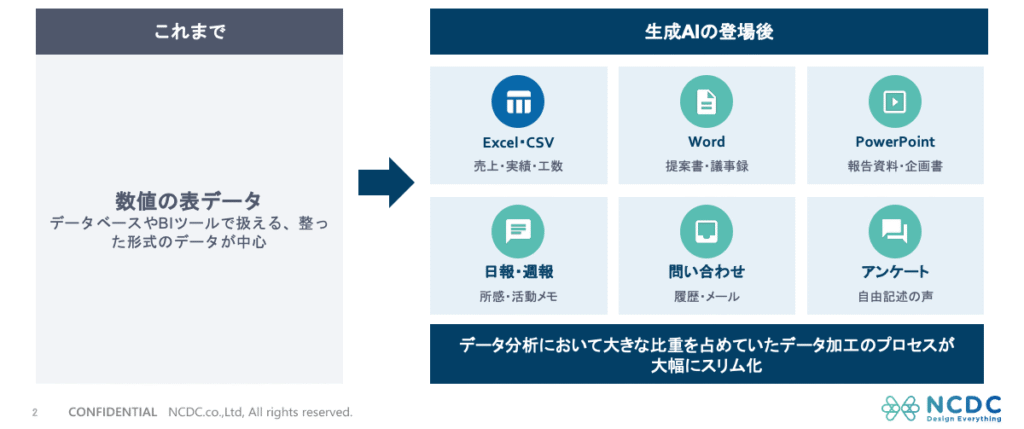
かつては、自由記述の自然言語を解析するためには高度な専門知識が必要でした。しかし今では、AIに自然言語のファイルを渡して「ここからこういう結果を出してほしい」と指示するだけで、AIが内容を適切に解読し、答えを出してくれます。
また、従来のデータ分析において作業全体の大きな比重を占めていた「データの加工やクレンジング」のプロセスも、AIによって大幅にスリム化されています。これもリードタイムの短縮に大きく貢献しています。
このように、必ずしも外部の技術者にデータ分析を依頼する必要がなくなったため、コストや時間の使い所が以前とは根本的に変わってきているのが現在のデータ分析の実務です。
実務担当者による身近なAIデータ活用事例
外部の専門家に頼らず、実務担当者自身がAIを用いてどのようにデータを活用しているのか、具体的な事例を3つご紹介します。
事例1:社員の稼働率分析システム
当社(NCDC)では、各社員がアサインされたプロジェクトの中で「何日稼働する計画か」「実際に何日稼働したか」を勤怠システムに登録しています。以前は、これらのデータを持っていても、プロジェクト単位の予実管理に利用する程度にとどまっていました。
しかし、最近、この実績データをcsvファイルで取り出し、AIを活用することで「部門別・月別の稼働率を集計し、推移と内訳を確認できる稼働分析ダッシュボード」を構築しました。
このダッシュボードでは、社員一人ひとりの計画と実績の比較はもちろん、プロジェクトごとの集計や、全体の稼働率の傾向など、さまざまな観点のグラフで可視化できます。
もし、従来型のシステム開発手法で、このダッシュボードの開発を外部に依頼していたら、およそ半年間の期間と3,000万円規模の費用がかかっていたかもしれません。そのようなものを、技術者ではないコーポレート部門の担当者が、業務の合間にAIと何度も対話(壁打ち)を繰り返すことで、合計3日ほどの工数で作り上げてしまいました(※社内でのみ活用するものであり、高度な設計は不要な仕組みです)。
事例2:製造業における設備故障の兆候探索
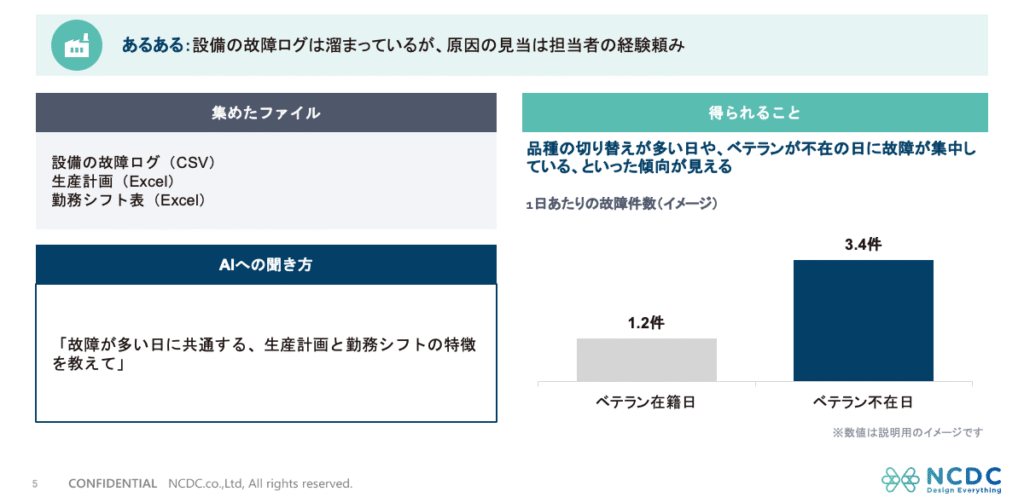
製造業の現場では、設備の故障ログは蓄積されているものの、故障の兆候を察知したり原因に見当をつけたりするのは「現場担当者の勘や経験頼り」というケースが少なくありません。
このような課題に対しても、手元のデータと生成AIを活用した改善を試みることができます。
たとえば、「設備の故障ログ(CSV)」「生産計画(Excel)」「勤務シフト表(Excel)」のデータをAIに渡し、「故障が多い日に共通する、生産計画と勤務シフトの特徴を教えて」と指示を出します。
すると、AIは即座にデータを解析し、「ベテランがいる日は故障が1〜2件しか起きていないのに、ベテランが不在の日は3〜4件起きている」といった傾向や、「製造品種を切り替えた初日に故障が起こりやすい」といった傾向を即座に見抜いて提示してくれます。
事例3:小売業における店舗訪問と売上の相関関係
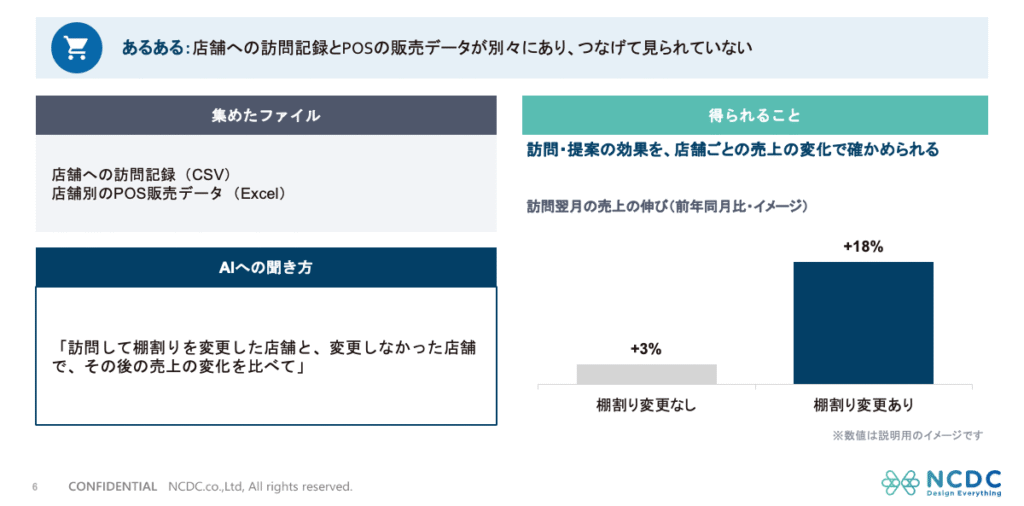
小売業で「スタッフの店舗への訪問記録」と「POSの販売データ」は、別々に管理されていることが多く、紐付けて分析されていないことがよくあります。
この2つのデータをAIに渡して「スタッフが訪問して棚割りを変更した店舗と、変更しなかった店舗で、その後の売上の変化を比べて」と指示を出します。すると「棚割りの変更があった場合は売上にこれだけのインパクトがあった」というような解析結果を、専門家に頼むことなく数分で得ることができます。
AIの分析結果を鵜呑みにしないために
上記のように、ファイルを集めてAIに渡せば、専門知識を持たずともわずか数分で答えが得られます。
しかし、AIが出してきた解析結果や意思決定の提案を、そのまま鵜呑みにしてマネージャーに報告したり、重要な業務判断に適用したりするのは非常に危険であるという現実も理解しておく必要があります。
意思決定や判断において、「どこで間違えるか」は大きく3つのステップに分けられます。
- データが間違っている: そもそも見ているデータが誤っていれば、その後の検討も意思決定もすべて誤ってしまいます。
- 検討方法が間違っている: データが正しくても、課題の定義や分析の切り口が誤っていれば、検討プロセスがブレてしまいます。
- 結論の出し方が間違っている: 検討結果が正しくても、どのような視点で結論を出すか(A案にするかB案にするか)の判断を誤る可能性があります。
AIを使うケースに限った話ではないですが、AIを活用する場合は特に「データは正しいか」「AIへの指示(プロンプト)は曖昧ではないか」「AIの結論の出し方は妥当か」を念入りにチェックする必要があります。
データを正しい意思決定に活かす3つのポイント
続いて、ケーススタディを通じて、具体的なチェックポイントを深掘りして解説します。
【ケーススタディ】
ある企業の営業担当者が、手元にある「案件リスト」「客先訪問記録」「営業日報」の3つのファイルをAIに渡し、「業種別の受注率を出した上で、来期注力すべき業種を教えて」と質問しました。
AIは即座に業種別の受注率を計算し、「受注率が最も高い『製造業』に注力すべきです」と回答しました。
果たして、この結果をそのまま信じて良いのでしょうか?
以下の3つの観点で確かめる必要があります。
チェックポイント1:データが誤っていないか
1つ目は、AIに渡している「元のデータ」が間違っていないか、という観点です。
例えば、全部で210件の案件データがあったとします。
- 空欄(欠損値)の扱い
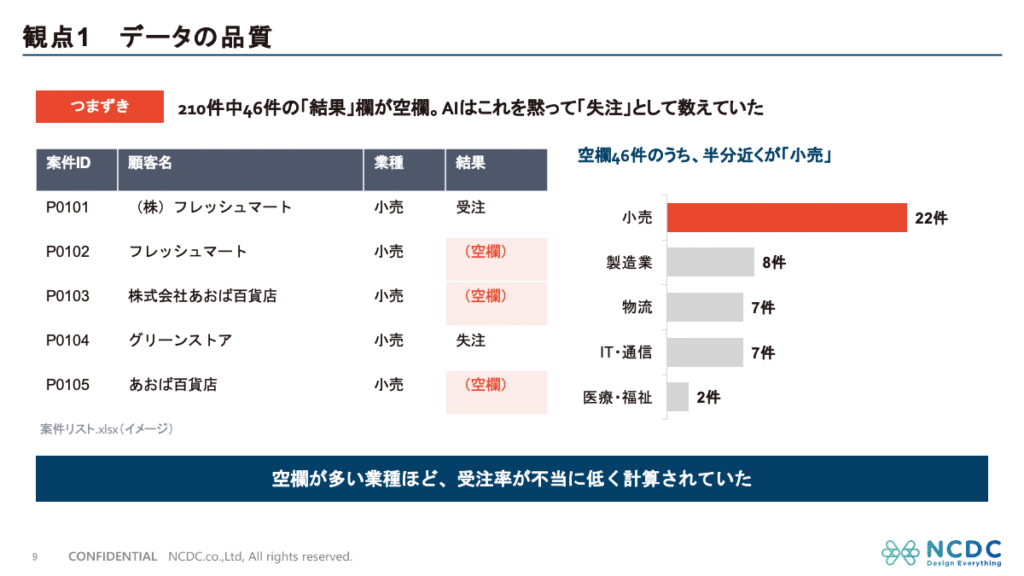
210件中、46件の結果欄(受注/失注)が、実は「空欄」でしたが、AIはこれを勝手に「失注」として計算していました。空欄の多くが小売業の案件であり、実際には受注しているのに記入が漏れていた場合、小売業の受注率が不当に低く算出されてしまいます。このように空欄をどう取り扱うかは、結果を左右する極めて重要な要素です。 - 表記揺れ(名寄せ)
顧客名の列を見ると、「株式会社あおば百貨店」「あおば百貨店」のように前株の有無があったり、末尾にスペースが入っていたり、カタカナが全角・半角で揺れているデータが存在します。実際の顧客は37社しかないのに、表記揺れのせいでデータ上は80種類もの顧客が存在することになっていました。
【このケースでの「データ品質の確かめ方」と改善方法】
分析の前に、AIに対して「各列の空欄の数と、値の種類を一覧にして」と指示し、データの健康診断を行います。これで受注・失注を記録する欄に未入力が存在することや、実際の顧客数は37社なのに、データ上80社あるように見えていることがわかります。
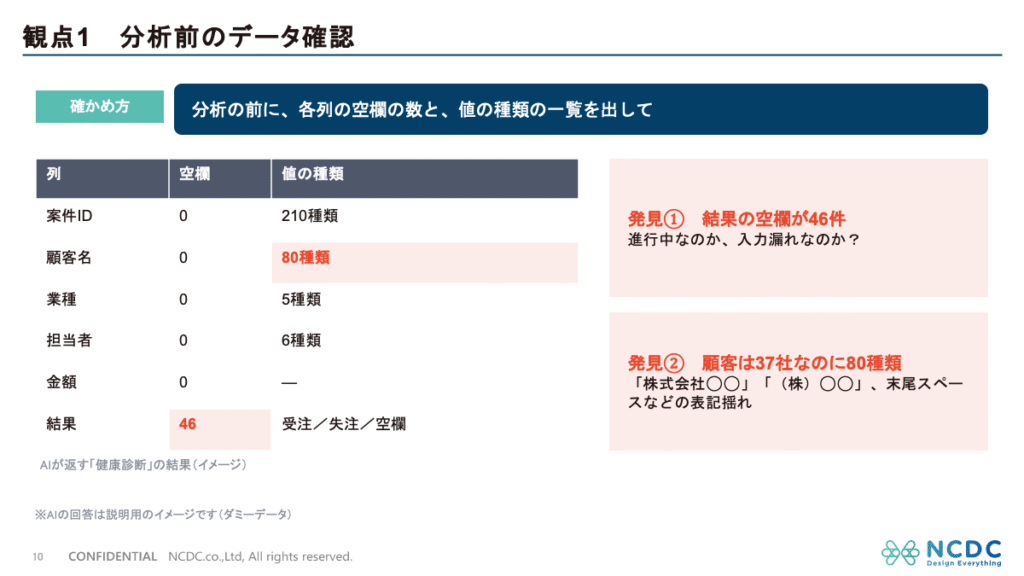
空欄の46件について実際の営業担当者に確認したところ、「37件は受注・失注の結果が出ていない進行中の案件であること、9件は失注の入力漏れであること」が判明しました。そこで、「進行中は除外、入力漏れ9件は失注として扱って。顧客名は表記を統一してから再計算して」とAIにルールを与えます。
この修正の結果、元々は「製造業が1位、小売業が2位」だった受注率が逆転し、「小売業が1位、製造業が2位」となりました。この時点で、最初の「製造業に注力すべき」というAIの回答は根底から覆ってしまいました。
かつてはデータサイエンティストが細かくプログラムを書いて欠損値処理や名寄せを行っていましたが、今は人間がルールさえ決めれば、データクレンジング作業自体はAIが自然言語の指示に従い、綺麗に行ってくれます。
チェックポイント2:分析の仕方が誤っていないか
2つ目は、AIに対する問いの定義や、データの切り口が曖昧ではないかという観点です。
データ品質のチェックを終えたら、次に、「受注を増やすにはどうすればいいか」とAIに質問してみました。するとAIは客先への訪問回数に着目し、「訪問回数が多いほど受注率が高いので、訪問を増やすべきです」と回答しました。
データを見ると、確かに「7回以上訪問したお客様の受注率は73%、4〜6回だと35.6%、0〜3回だと9.5%」となっており、訪問回数が多いほど受注率が高そうに見えます。
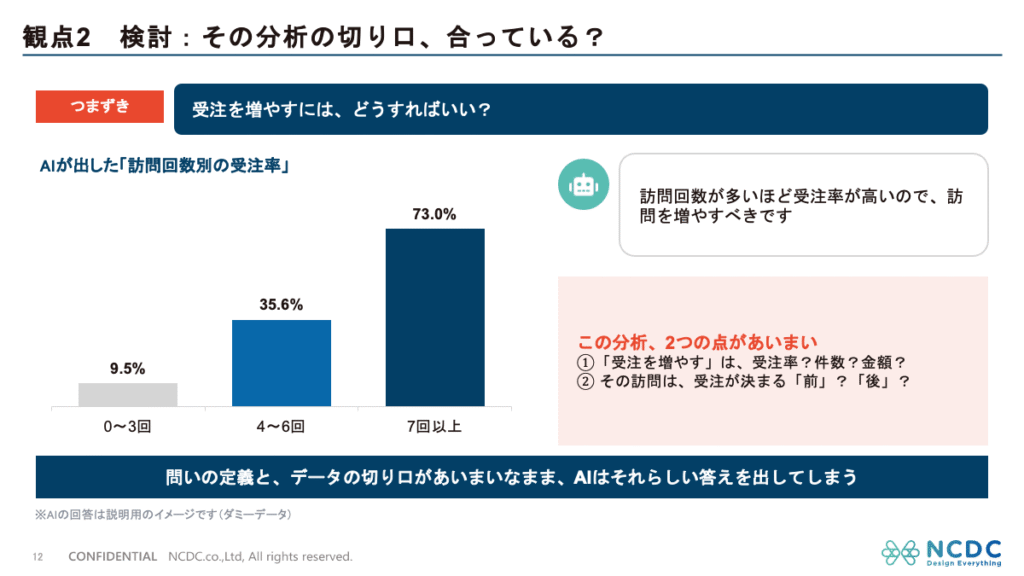
しかし、この分析には2つの曖昧な点が残っています。
- 目的の曖昧さ: 「受注を増やす」とは、受注「率」の話なのか、「件数」の話なのか、それとも「金額」の話なのかが曖昧です。
- タイミングの曖昧さ: その訪問は、受注が「決まる前」の訪問なのか、「決まった後」の訪問なのかが区別されていません。
厳密に仕事を進める人間であれば、「受注って率のこと?件数のこと?」と確認をとるはずですが、AIは指示が曖昧なままでも、一旦それらしい答えを出してしまいます。これがAIらしさであり、落とし穴でもあります。
【このケースでの「検討の「曖昧さ」の確かめ方」と改善方法】
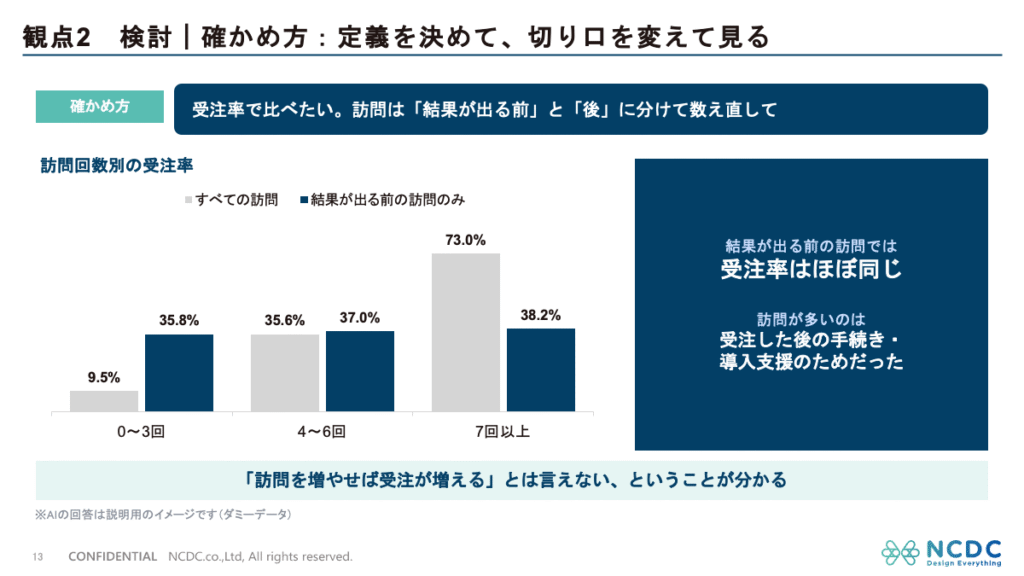
曖昧さを排除するため、AIに「受注率で比べたい。訪問については、結果が出る『前』と『後』に分けて数え直して」と明確な指示を出します。
その結果、「結果が出る前の訪問回数に絞ると、何回訪問しようが受注率はほとんど同じ」であることが判明しました。最初にAIが提示した「7回以上訪問で受注率73%」という数字は、受注が決まった後の手続きやアフターフォローのための訪問が多かっただけだったのです。これにより、「必ずしも訪問を増やせば受注が増えるという簡単な話ではない」ということが明確になりました。
チェックポイント3:結論の出し方が誤っていないか
3つ目は、導き出された結論の出し方が妥当かという観点です。
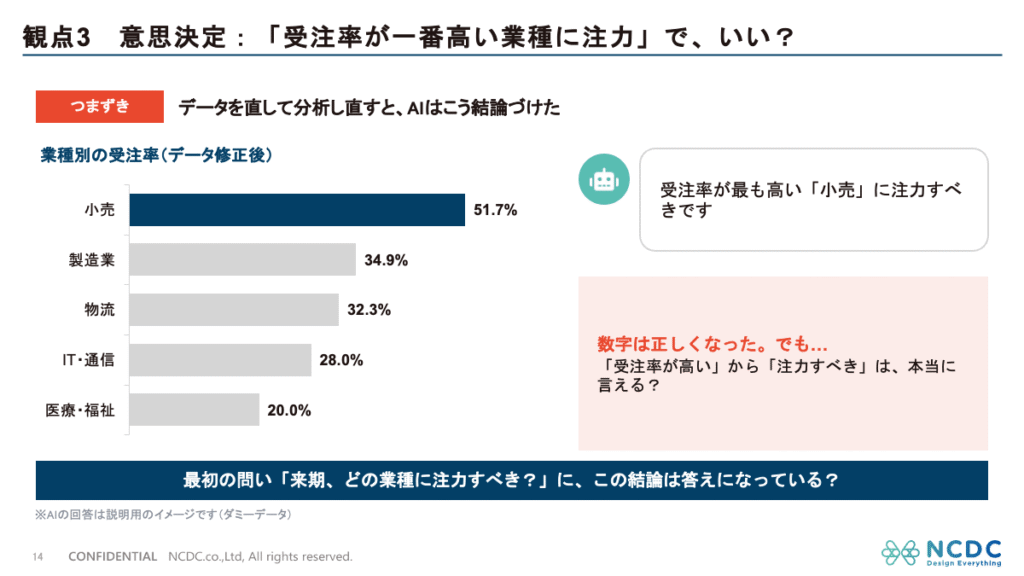
データを正しく修正して再分析した結果、AIは「受注率が最も高い『小売業』に注力すべきです」と結論づけました。しかし、「受注率が高いからその業界に注力すべき」という判断をそのまま信じて良いのでしょうか。
一度テーマを変えて「設備の故障率」の例で考えてみます。
「故障率が高いからその設備を交換すべき」という考え方がある一方で「故障回数は多くてもすぐに直せて影響が小さい設備よりも、1回の故障あたりのダウンタイムがもっとも長い設備を優先して更新すべき」という考え方もあります。
表に出やすい「率」だけに注目するのではなく、何パターンもの考え方を用意し、多面的な視点で正しい結論を導き出すことが大切です。
【このケースでの「意思決定の妥当性」の確かめ方と改善方法】
目的に立ち戻り、別の見方でもデータを比較するようAIに指示したり、人間自身が考えたりします。
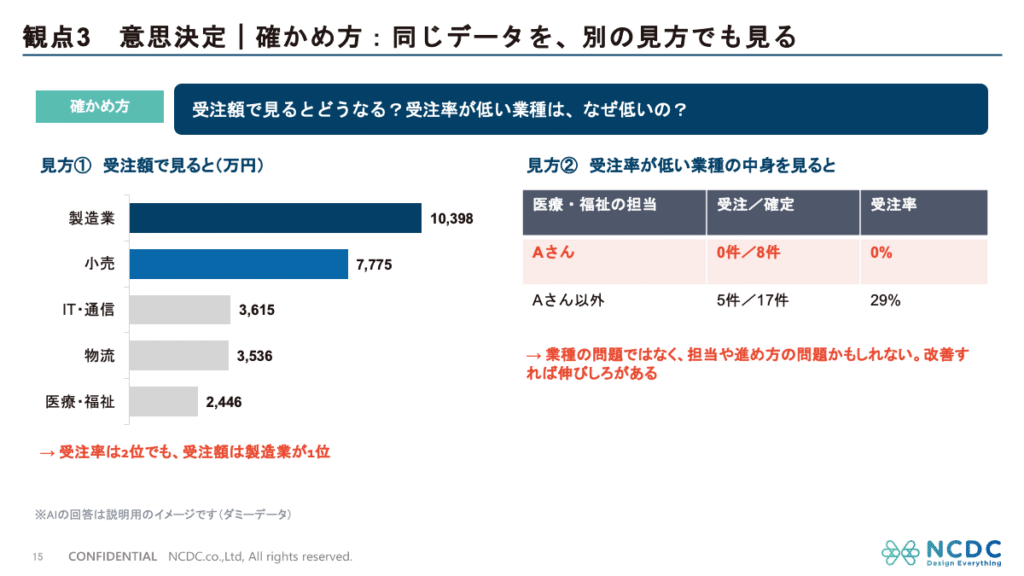
- 受注額で見る:「受注率」は小売業が1位でも、「受注額」で見直すと製造業の方が高い場合はどうでしょうか。大型案件を確実に取るために、製造業を伸ばしていくという方針も立てられます。売上の金額を伸ばしたいのであれば、「受注率」を見るよりも「受注額」に着目し、製造業に注力するのが正解になります。
- 伸びしろで見る: 受注率も受注額も低い「医療・福祉」業界について、担当者別にブレイクダウンして確認すると、特定の担当者の成績が著しく低かったとします。これは業種の問題ではなく、担当者に課題がある証拠です。裏を返せば、この担当者の進め方を改善すれば最も「伸びしろ」がある領域かもしれません。
AIが提示した答えは、「一つの見方(このケースの場合は受注率)」から導き出されたものにすぎません。
そもそも我々は「どういう目的のもとに意思決定をしたいのか」にしっかりと立ち戻り、現場の実感やマネージャーの認識、経営方針(中期計画・短期計画など)とすり合わせて、最終的な方針を決めていくことが重要です。
AIのハルシネーションを見抜くには
AIを活用する上で避けて通れないのが、「ハルシネーション(AIがもっともらしい嘘をついてしまう現象)」です。ハルシネーションを完全に見抜くことは非常に難しいですが、鵜呑みにせず「見抜ける形を持っておく」ことが極めて重要です。
次の4つの確認を行うだけでも、AIを盲信して失敗するリスクを低減することができます。
- 根拠の場所を言わせる
AIが「Aである」と回答した場合、「どのファイルの、どの行の、どの記述からその答えを導き出したのか」をAIに答えさせます。業務で扱うデータは行も列も膨大な「お化けExcel」になりがちで、人間が自力で探すのは困難です。AIにピンポイントで該当箇所を提示させ、その原文を自分で直接確認します。すると「全然違う意味で使われている」「そもそも内容を読み間違えている」といったハルシネーションを発見できます。間違っていればAIに指摘して教えることで、AIをより賢く成長させることも可能です。 - 計算は「表・式」で出させる
計算結果の数字だけを文章で示してもらうのではなく、集計表や計算式など、AIが考えたプロセスを出力させて、自分の目で確認します。 - 知っている数字と突き合わせる
AIが算出した受注件数などが、手元にある営業支援システムなどの確実なデータと一致するかを突き合わせます。 - 数件だけ手で検算する
AIに計算させた内容のうち、数件だけでも手元で実際に検算してみることも、見落としを防ぐための有効な手段です。
現場人員によるAI分析の限界と専門家の必要性
生成AIによって、現場の実務担当者が他部署や外部業者に頼らず、データ分析を行えるようになりました。しかし、手元で行うAI分析はあくまで「自分や少人数のチームのためのもの」「傾向を確かめて仮説を立てるためのもの」であり、限界があります。
その先に進むためには、専門家の力が必要不可欠になる領域がまだまだ存在します。例えば、データ分析やシステム開発の専門知識を持たない人材だけで、次のような要望まで満たすことは困難です。
- 全社共有や業務の自動化(システム化)
分析結果を全社で共有したい、毎日自動で更新して異常を通知したい、既存の業務システムと連携させてオートメーション化したいといった要望がある場合、システムベンダーや情報システム部門との連携が必要です。 - 予測や推論モデルの構築
需要予測システムや予知保全システムなど、機械学習のモデルを取り込んで現在稼働しているシステムに組み込む場合、プロトタイプ以上のものを作るにはデータサイエンティストなど専門家の知見が必要です。AWSやAzureなどのクラウドサービスにより開発の手間は減っていますが、現場の創意工夫だけで作り切るよりは、プロに任せたほうが安心な領域です。 - 高度なセキュリティ・非機能要件の担保
実務担当者がシステムを作ろうとすると、どうしても「機能面(やりたいこと)」にばかり目が行きがちです。しかし、昨今ニュースを賑わせている情報漏洩を防ぐためには、セキュリティ、性能、可用性といった「非機能要件」の設計が必須です。この部分はセキュリティを深く理解している人間の知識が欠かせません。
業務をよく知る現場担当者の役割
AIがデータ分析を手軽にしてくれた分、業務を一番よく知る実務担当者の「いや、これはちょっとおかしいんじゃないか」という感覚や、「こういう観点もあるのではないか」という経験に基づく分析結果に対しての判断・レビューが、これまで以上に重要になってきます。
AIの処理能力と、人間の思考力・経験を組み合わせることで、よりスムーズでスマートな業務を実現していきましょう。
IT部門の方などが社内のAI活用促進を図る場合、情報セキュリティを維持するためのルールと共に、こうした「データとの向き合い方」も各部門へ伝えておくと有効です。
データ分析基盤構築やAI活用のご相談はNCDCへ
NCDCでは、こうしたAI活用のノウハウをお伝えするセミナーを個々のお客様に合わせて提供したり、生成AIを活用するためのワークショップを提供したり、さまざまなサポートを行っています。
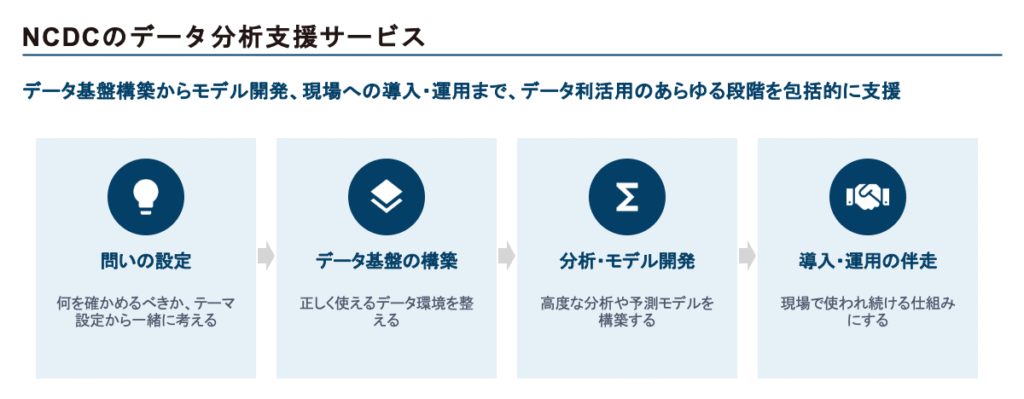
より高度なデータ分析に取り組みたい方向けには、分析のクエスチョン設定(問いの設定)から、正しく使えるデータ基盤の構築、高度な分析・予測モデルの開発、そして現場への導入や運用の伴走まで、データ利活用のあらゆる段階を包括的に支援する「データ分析支援サービス」も提供しています。
「社内にデータは蓄積されているが、AIを使ってどう分析していいかわからない」
「手元でのAI活用から一歩進んで、全社的なシステムや予測モデルを構築したい」
「セキュリティや非機能要件を担保した安全なAI・データ基盤を作りたい」
このような課題をお持ちの企業様は、ぜひ一度NCDCにご相談ください。技術とビジネスの両面に精通した専門チームが最適な解決策をご提案いたします。
資料公開
本記事は、2026年10月15日に実施したオンラインセミナー「AIで変わるデータ分析|現場の実務者が主役となりデータを正しい意思決定に活かす仕事術」の内容をもとに要点を解説しています。
セミナー動画やセミナー当日に用いた資料(スライド)は下記リンクからご覧ください。